AI 에이전트를 만들었다고 해서 항상 원하는 결과가 나오는 것은 아닙니다. 같은 질문을 입력해도 다른 답을 내놓을 수 있고, 상황에 따라 잘못된 도구를 사용하거나 중간 단계에서 판단을 잘못할 수도 있습니다.
그래서 실제 AI 서비스를 만들 때 중요해지는 개념이 바로 평가, 즉 Evaluation입니다. AI 분야에서는 흔히 이를 줄여서 Evals라고 부릅니다.
정답 여부만 보는 대신 목표 준수, 도구 선택, 최종 결과처럼 정해 둔 기준으로 평가할 항목을 확인합니다. 도구 호출의 세부 실행 흐름은 Evals 결과만으로 모두 알 수 있는 것이 아니므로 필요하면 Tracing을 함께 살펴봅니다.
최초 발행일: 2026년 10월 4일 · 최종 수정일: 2026년 11월 4일
AI 에이전트 평가란 무엇일까?
일반적인 프로그램은 같은 입력을 넣으면 대부분 동일한 결과가 나옵니다.
하지만 생성형 AI는 다릅니다. 같은 질문에도 표현이나 판단 과정이 조금씩 달라질 수 있습니다. 특히 AI 에이전트는 검색, 데이터 조회, 외부 도구 사용처럼 여러 단계를 거치기 때문에 확인해야 할 부분이 더 많습니다.
예를 들어 여행 계획을 만드는 AI 에이전트가 있다고 생각해 보겠습니다.
사용자가 서울에서 도쿄로 3박 4일 여행 일정을 만들어 달라고 요청했다면 단순히 일정표가 만들어졌다는 사실만으로 좋은 결과라고 판단하기 어렵습니다.
항공편 정보를 제대로 확인했는지, 존재하지 않는 장소를 추천하지 않았는지, 이동 시간이 현실적인지, 사용자가 요청한 예산을 지켰는지도 확인해야 합니다.
이처럼 AI가 작업을 얼마나 정확하게 수행했는지를 일정한 기준으로 측정하는 과정이 Evaluation입니다.
일반 프로그램 테스트와 무엇이 다를까?
전통적인 소프트웨어에서는 특정 입력에 대해 예상한 출력이 나오는지 확인하는 방식이 많이 사용됩니다.
AI 시스템은 결과가 매번 조금씩 달라질 수 있기 때문에 단순히 정답 하나와 비교하는 방식만으로는 부족합니다.
따라서 AI 평가에서는 여러 기준을 함께 사용합니다.
대표적으로 정확성, 지시사항 준수 여부, 안전성, 필요한 도구 선택 여부, 결과의 완성도 등을 평가할 수 있습니다.
최근에는 AI의 최종 답변뿐 아니라 작업 과정까지 확인하는 방식도 중요해지고 있습니다.
Evals는 정해 둔 기준에 따라 여러 사례의 결과를 평가하고, Tracing은 개별 실행이 어떤 단계로 진행됐는지 기록합니다. 두 방식은 서로 보완합니다. 자세한 실행 추적은 AI 에이전트의 Tracing 안내에서 확인할 수 있습니다.
AI 에이전트는 왜 평가가 더 어려울까?
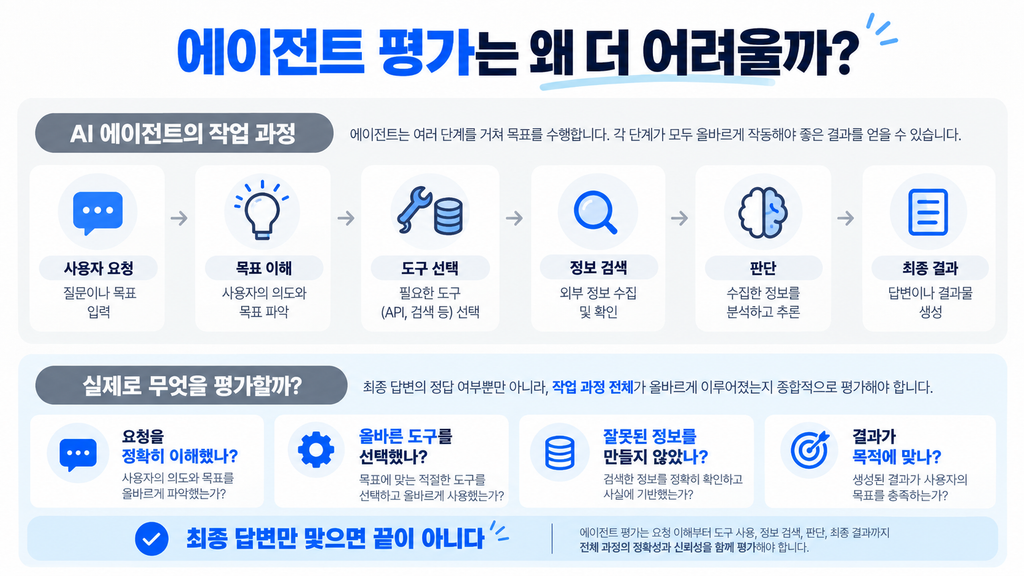
AI 에이전트는 일반 챗봇보다 수행하는 작업이 복잡합니다.
단순 챗봇은 질문을 받고 답변하는 과정이 중심이지만 에이전트는 목표를 달성하기 위해 여러 단계를 스스로 진행할 수 있습니다.
예를 들어 자료를 검색하고, 검색 결과를 분석하고, 필요한 정보를 다시 찾은 다음 최종 보고서를 작성할 수 있습니다.
문제는 이 과정 중 한 단계만 잘못되어도 최종 결과가 크게 달라질 수 있다는 점입니다.
Anthropic도 공식 글 Demystifying evals for AI agents에서 에이전트가 여러 Turn에 걸쳐 도구를 호출하고 상태를 변경하며 중간 결과에 적응하기 때문에 평가가 더 복잡해진다고 설명합니다.
따라서 에이전트 평가에서는 최종 답변뿐 아니라 중간 과정에서 어떤 판단을 했는지도 살펴볼 필요가 있습니다.
실제로 무엇을 평가할까?
AI 에이전트를 평가할 때는 다음과 같은 질문을 사용할 수 있습니다.
- 사용자의 요청을 정확하게 이해했는가?
- 필요한 도구를 적절하게 선택했는가?
- 잘못된 정보나 존재하지 않는 내용을 만들지 않았는가?
- 작업 순서가 합리적이었는가?
- 최종 결과가 사용자의 목적을 충족했는가?
서비스에 따라 평가 기준은 달라질 수 있습니다. 안전과 권한이 중요한 작업은 평가 기준과 실행 중 통제를 구분해 살펴보세요. 관련 내용은 AI 에이전트 가드레일 안내를 참고할 수 있습니다.
고객 상담 AI라면 답변 정확도와 문제 해결률이 중요할 수 있고, 코딩 에이전트라면 실제 코드가 실행되는지가 더 중요한 평가 기준이 될 수 있습니다.
가상 분류 사례로 정확도 계산하기
다음은 고객 문의 자동 분류를 설명하기 위한 가상의 평가 예시입니다. 실제 모델 시험, 운영 데이터, 측정 결과 또는 통계적 검증이 아닙니다. 이 예시에서는 AI 분류와 정답 범주가 정확히 일치하면 통과로 판정합니다.
| 고객 문의 | AI 분류 | 정답 | 판정 |
|---|---|---|---|
| 배송이 늦어요 | 배송 | 배송 | 통과 |
| 환불하고 싶어요 | 교환 | 환불 | 실패 |
| 주소를 변경해 주세요 | 배송 | 배송 | 통과 |
| 상품이 파손됐어요 | 교환 | 교환 | 통과 |
| 결제 취소해 주세요 | 환불 | 환불 | 통과 |
이 가상 표에서는 정답 5건 중 4건이 통과했습니다. 정확도 계산은 정답 4건 ÷ 전체 5건 × 100 = 80%입니다. 이 80%는 표의 가상 사례에 대한 산술 결과일 뿐, 실제 서비스의 정확도나 충분한 성능 검증을 뜻하지 않습니다.
자동 평가도 가능하다
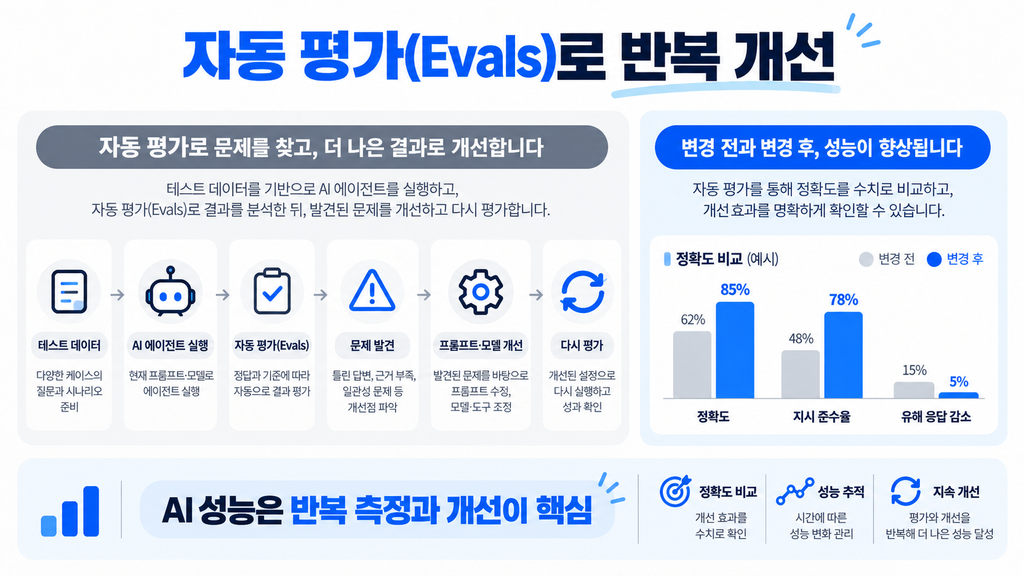
모든 AI 결과를 사람이 직접 확인하는 것은 현실적으로 어렵습니다.
그래서 일정한 평가 기준을 만들어 자동으로 결과를 측정하는 방법이 사용됩니다.
예를 들어 좋은 답변이 갖춰야 할 조건을 미리 정의하고 여러 테스트 데이터를 반복해서 실행할 수 있습니다.
새로운 모델이나 프롬프트를 적용했을 때 이전보다 성능이 좋아졌는지 비교하는 데도 활용할 수 있습니다.
평가 도구는 테스트 입력, 프롬프트, 판정 기준과 결과를 함께 관리할 수 있지만 제공 기능은 서비스와 버전에 따라 다릅니다. 도구를 선택할 때는 현재 지원 일정과 이전 가능한 데이터 범위를 확인해야 합니다.
OpenAI Evals 서비스 일정과 이전 선택지
2026년 11월 4일 확인한 공식 일정상 기존 Evals는 10월 31일 읽기 전용 전환일이 지났으며, 대시보드와 API는 11월 30일 종료 예정입니다. 기존 사용자는 지금 접근 가능한 평가의 입력·프롬프트·모델 설정·채점 기준과 비교용 결과를 보존하고, 이를 Promptfoo 설정으로 수동 재구성할 준비를 하세요. 공식 이전 안내는 전용 내보내기 기능을 전제하지 않습니다. 재구성 후에는 같은 테스트 사례로 판정 기준과 출력을 비교해야 하며, 특히 LLM 채점기의 숫자가 이전과 같다고 가정하면 안 됩니다. 이는 평가 방법론 자체의 종료를 뜻하지 않지만, 기존 Evals 대시보드와 API를 장기 사용 대안으로 전제해서는 안 됩니다.
OpenAI가 공개한 Promptfoo 이전 안내를 참고할 수 있습니다. Promptfoo는 OpenAI의 Evals 서비스와 별개의 오픈 소스 평가 도구이며, 기존 평가가 자동으로 이전된다는 뜻은 아닙니다.
OpenAI의 Datasets 안내는 프롬프트와 테스트 데이터를 반복적으로 다루는 평가 실험 경로를 설명합니다. 다만 Datasets가 기존 Evals의 모든 기능을 자동 이전하는 도구나 장기적인 전체 대체재라고 단정해서는 안 됩니다. 접근 가능 여부와 필요한 기능을 별도로 확인하세요.
다른 평가 도구를 검토할 때는 모델·제공자 지원, 채점 기준 재현성, 데이터 보관 위치와 개인정보 처리, 결과 내보내기, 지속적 실행 환경을 비교해야 합니다. 자세한 일정은 OpenAI 지원 종료 공지에서 다시 확인하세요.
AI 시대에는 평가가 더 중요해진다
앞으로 AI 에이전트가 이메일 작성이나 검색처럼 단순한 업무를 넘어 실제 업무 프로세스를 처리하는 경우가 늘어날 가능성이 높습니다.
에이전트가 더 많은 일을 스스로 처리할수록 결과를 검증하는 장치도 함께 중요해집니다.
AI가 한 번 좋은 답을 만들었다는 것보다 다양한 상황에서도 일정 수준 이상의 결과를 지속적으로 만들어내는지가 더 중요하기 때문입니다.
결국 AI 에이전트의 경쟁력은 모델의 성능만으로 결정되지 않습니다.
어떤 도구를 제공하는지, 어떤 데이터를 연결하는지 그리고 결과를 얼마나 체계적으로 평가하고 개선하는지가 함께 중요해집니다.
AI 에이전트를 실제 서비스에 활용하려면 Evaluation은 부가 기능이 아니라 신뢰성을 높이기 위한 핵심 과정이라고 볼 수 있습니다.
공식 참고 자료
OpenAI Cookbook: Moving from OpenAI Evals to Promptfoo